Automação de Documentos com OCR e IA: Como Parar de Digitar Notas Fiscais e Contratos à Mão
Aprenda a automatizar a leitura de notas fiscais, boletos e contratos com OCR e IA. Ferramentas, etapas e cuidados para PMEs brasileiras ganharem tempo.
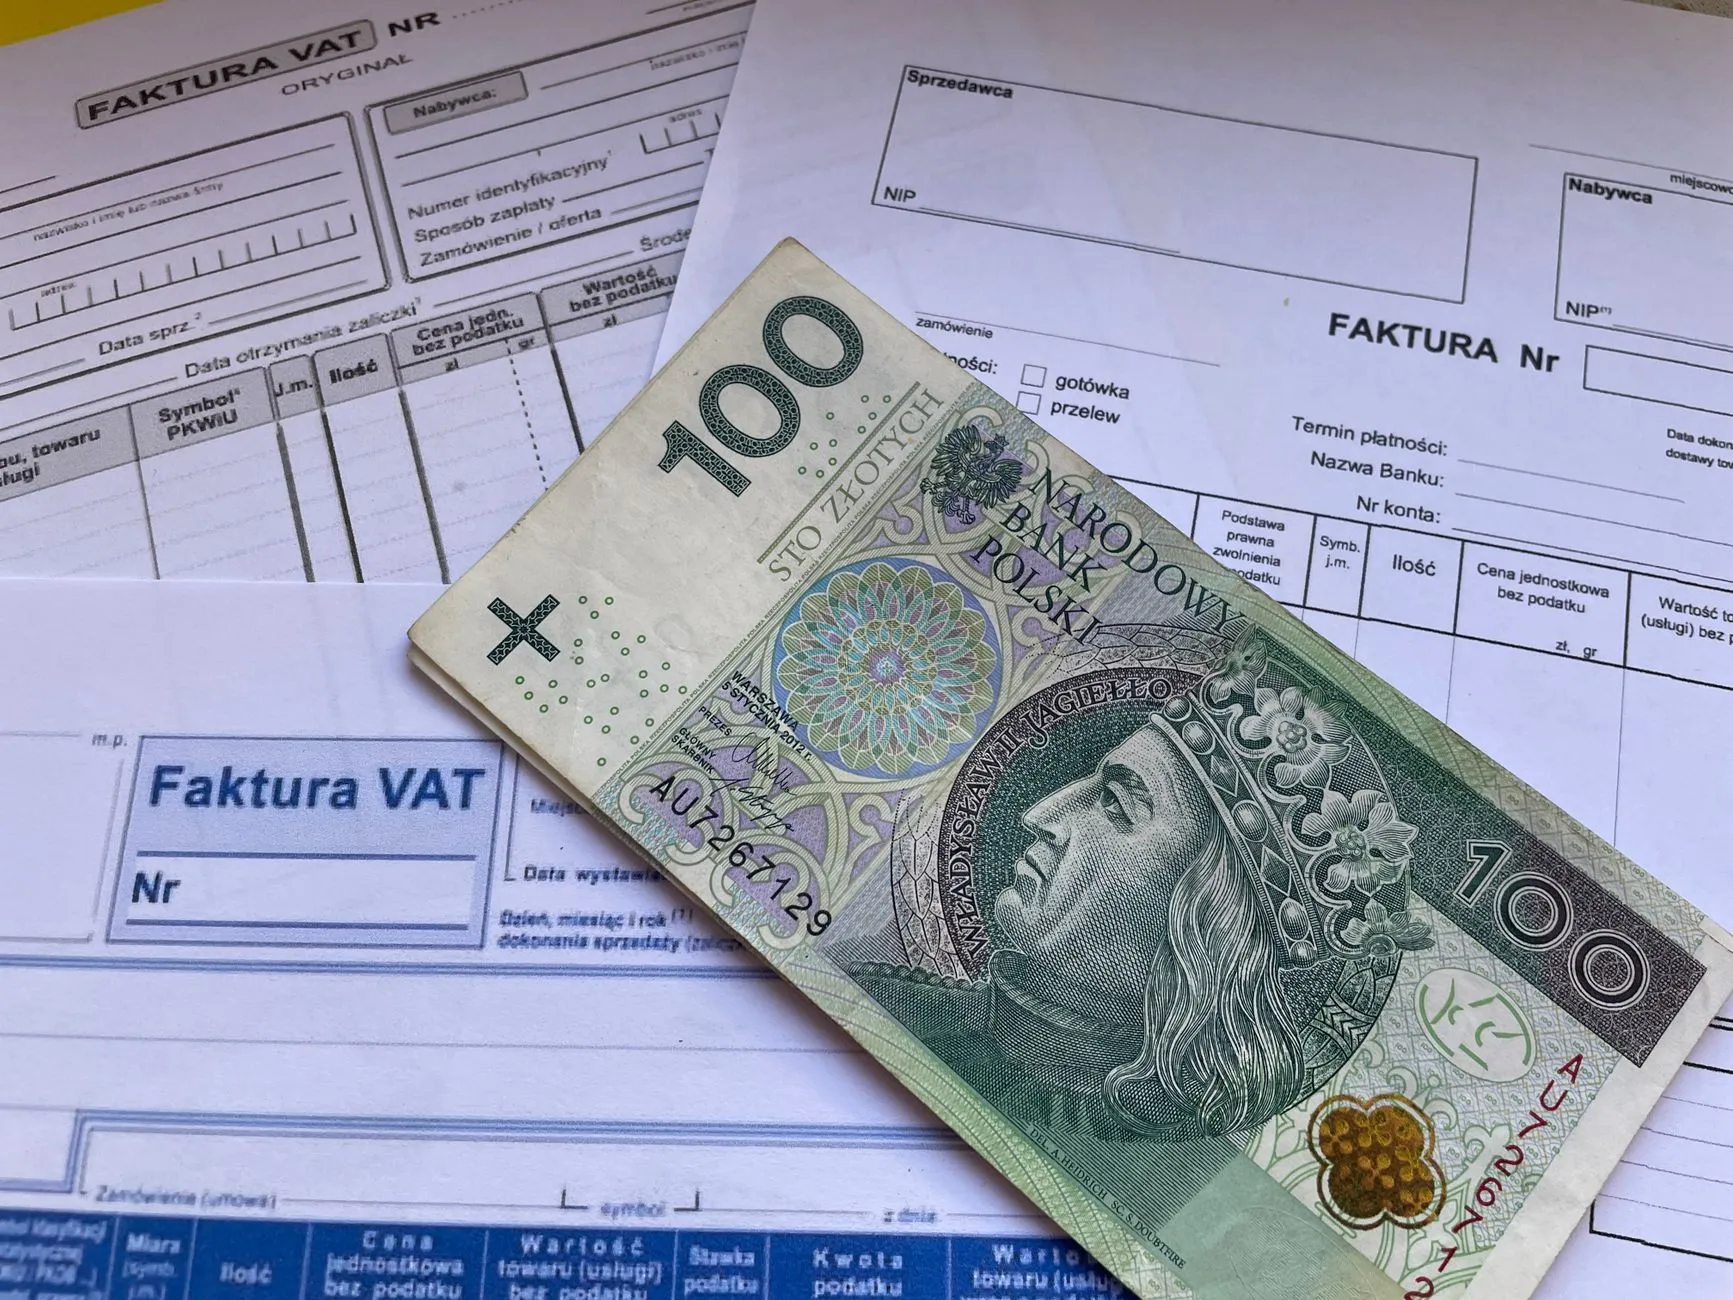
Em muitas empresas brasileiras, ainda existe uma pessoa cuja função informal é "passar nota". Ela recebe PDFs por e-mail, abre um por um, copia o CNPJ, o valor, o vencimento e a descrição dos itens, e cola tudo numa planilha ou no sistema de gestão. É um trabalho repetitivo, lento e propenso a erro de digitação. Um zero a mais num boleto pode virar dor de cabeça no fechamento do mês.
A boa notícia é que a combinação de OCR (reconhecimento óptico de caracteres) com modelos de linguagem permite automatizar boa parte desse trabalho, mesmo em empresas pequenas e sem time de TI dedicado. Este guia mostra como a tecnologia funciona, quais ferramentas existem, como montar um fluxo na prática e quais armadilhas evitar.
O que é OCR e por que ele ficou muito melhor nos últimos anos
O reconhecimento óptico de caracteres é a tecnologia que converte imagens de texto, como fotos, digitalizações e PDFs escaneados, em texto que o computador consegue processar. A ideia existe há décadas, mas o OCR tradicional tinha uma limitação séria: ele "lia" os caracteres, mas não entendia o que estava escrito. Para ele, o valor total da nota e o número do pedido eram apenas sequências de dígitos.
O cenário mudou por dois motivos. Primeiro, os motores de OCR modernos, baseados em redes neurais, lidam melhor com fotos tortas, papel amassado, carimbos por cima do texto e fontes ruins. Segundo, os modelos de linguagem atuais conseguem interpretar o contexto: eles identificam que determinado número é o valor total, que aquela data é o vencimento e que aquele bloco de texto é a razão social do fornecedor.
Na prática, isso significa que você deixou de depender de "modelos fixos" de documento. Antes, era preciso configurar a posição exata de cada campo para cada layout de fornecedor. Hoje, a IA extrai os campos mesmo quando o layout muda.
Quais documentos valem a pena automatizar primeiro
Nem tudo precisa de IA. A regra é simples: comece pelo que tem alto volume, formato razoavelmente previsível e custo alto de erro. No contexto brasileiro, os candidatos mais comuns são:
- Notas fiscais de entrada: o campo de dados é relativamente padronizado, e o volume costuma ser alto no financeiro e na contabilidade.
- Boletos e faturas: valor, vencimento, beneficiário e linha digitável são os campos críticos.
- Comprovantes de despesa: cupons e recibos de reembolso de viagens e deslocamentos, que chegam em foto de celular, geralmente de qualidade ruim.
- Contratos e aditivos: aqui o objetivo costuma ser extrair cláusulas, prazos de vigência e datas de renovação, e não digitar tudo.
- Documentos de cadastro: RG, CNH e comprovantes de endereço em processos de admissão ou onboarding de clientes.
Uma dica prática: se o documento já chega em formato digital estruturado, como o XML da NF-e, nem precisa de OCR. Ler o XML diretamente é mais barato e mais confiável. O OCR entra para o que chega como imagem ou PDF sem estrutura, como a NFS-e de alguns municípios, os boletos em PDF e os recibos fotografados.
Como funciona o fluxo completo, do e-mail ao sistema
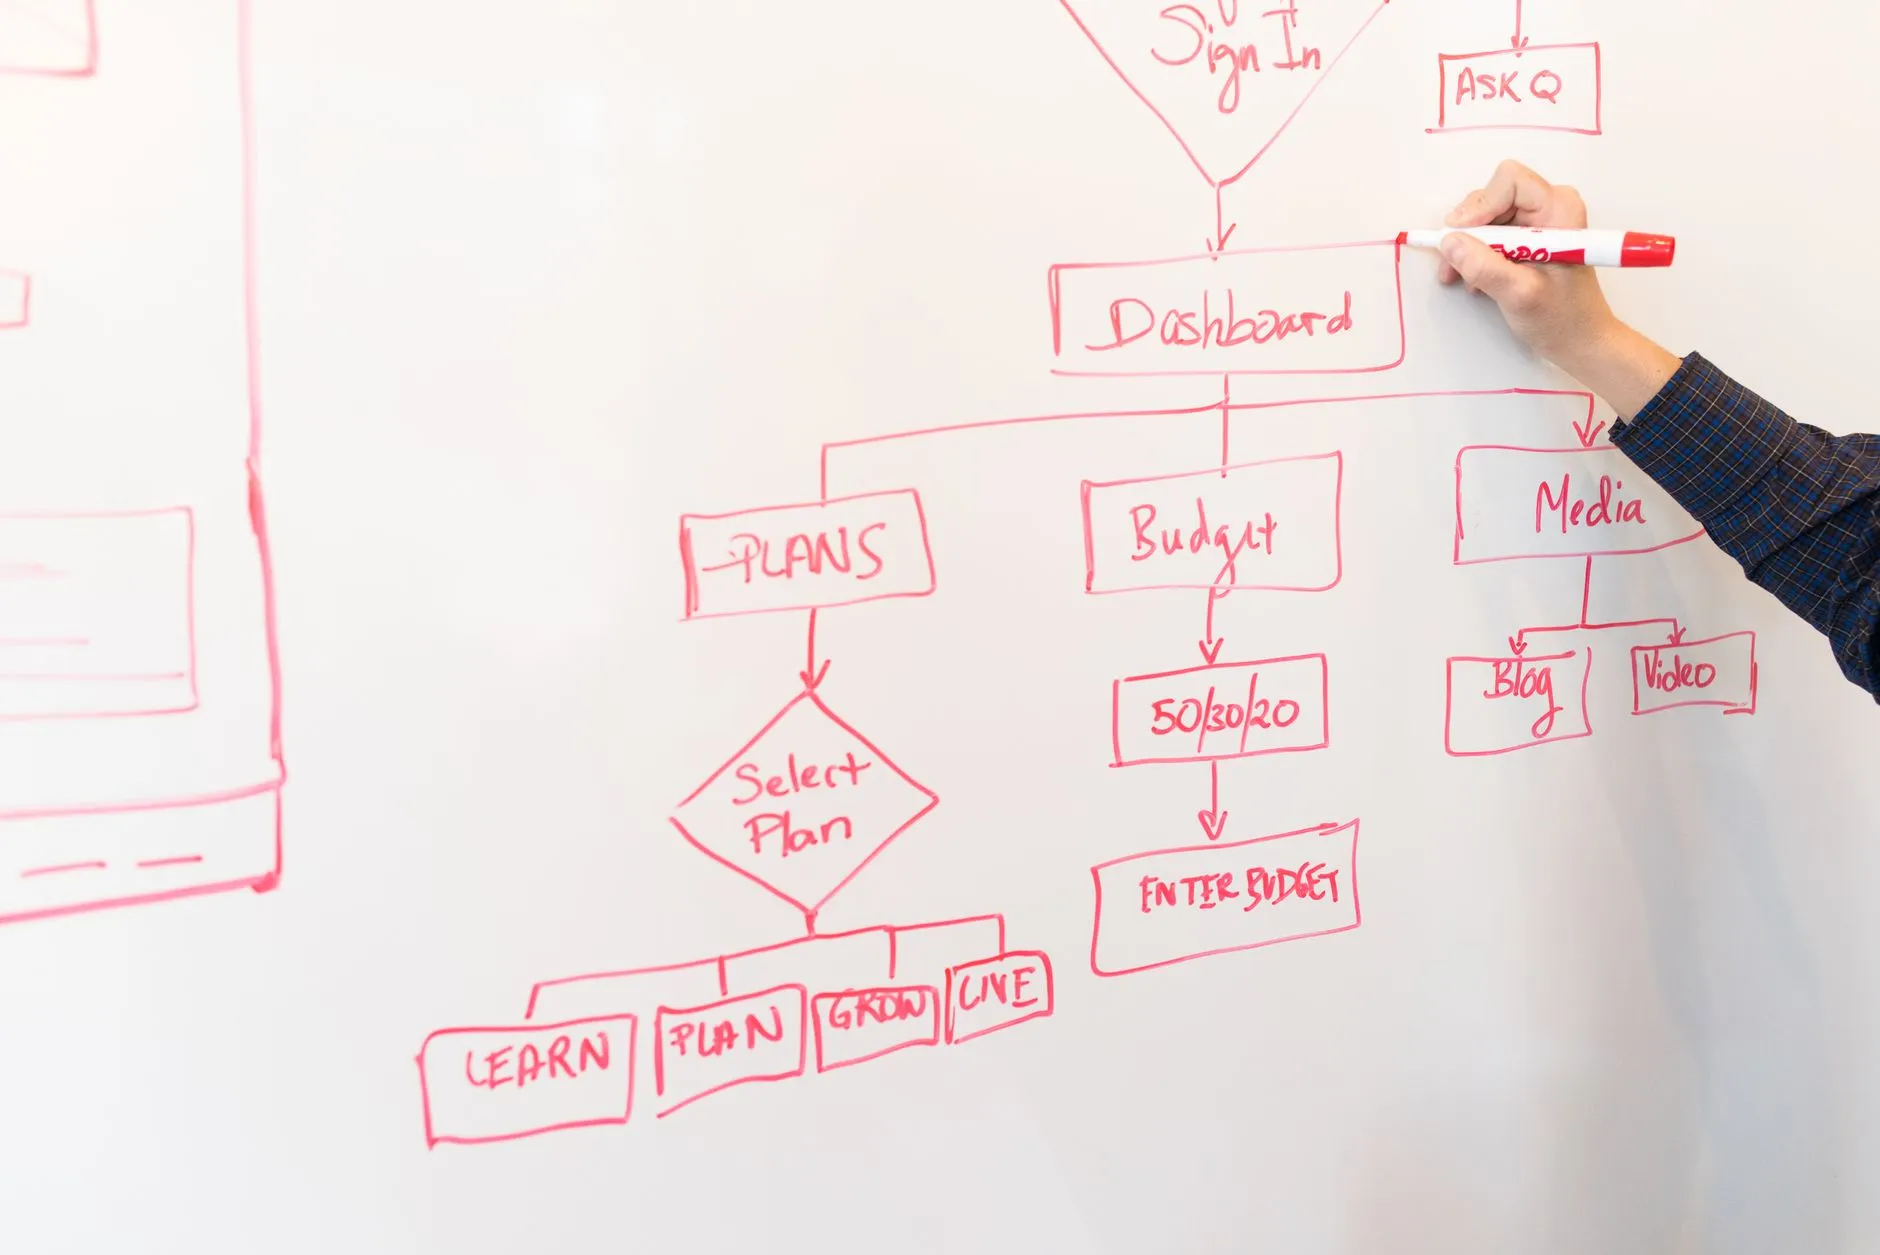
Um fluxo de automação documental bem montado tem cinco etapas. Entender cada uma ajuda a escolher onde investir e onde economizar.
1. Captura
É a porta de entrada dos documentos. Pode ser uma caixa de e-mail dedicada (por exemplo, [email protected]), uma pasta compartilhada na nuvem, um formulário de envio ou até um número de WhatsApp para fotos de recibos. O ideal é centralizar tudo num único ponto, para que a automação tenha onde "escutar".
2. Pré-processamento
Antes de ler, é útil melhorar a imagem: endireitar a página, remover ruído, aumentar o contraste e separar PDFs com várias páginas em documentos individuais. Muitas ferramentas de OCR já fazem isso sozinhas, mas em fotos muito ruins esse passo faz diferença na taxa de acerto.
3. Extração
Aqui o OCR transforma a imagem em texto, e um modelo de linguagem ou um serviço especializado em documentos identifica os campos. O resultado ideal é um conjunto de dados estruturados, como fornecedor, CNPJ, número, valor e vencimento, em vez de um bloco de texto corrido.
4. Validação
Esta é a etapa que separa uma automação confiável de uma fonte de problemas. Os dados extraídos precisam passar por regras de conferência: o CNPJ tem dígitos verificadores válidos? A soma dos itens bate com o total? O vencimento está no futuro? O fornecedor já existe no cadastro? Quando alguma regra falha, o documento vai para revisão humana, e não direto para o sistema.
5. Integração
Com os dados validados, o fluxo cria o lançamento no ERP, atualiza a planilha, agenda o pagamento ou dispara uma notificação. É aqui que o conhecimento de integração por APIs e de ferramentas de automação faz diferença. Se você pretende programar partes do fluxo, o guia de automação de processos com Python traz uma boa base.
Ferramentas disponíveis: das gratuitas às corporativas
O mercado se dividiu em algumas categorias, e a escolha certa depende do volume de documentos, do orçamento e da habilidade técnica da equipe.
Serviços de nuvem especializados em documentos
As grandes plataformas de nuvem oferecem serviços de análise de documentos que já entendem notas fiscais, faturas e recibos. A Document AI do Google Cloud, o Textract da AWS e o Document Intelligence da Microsoft Azure são exemplos conhecidos. Eles cobram por página processada, e o custo costuma ser baixo para volumes de pequenas e médias empresas, mas convém conferir a tabela de preços atual de cada provedor, já que ela muda com frequência e é cobrada em dólar.
OCR de código aberto
O Tesseract é o motor de OCR de código aberto mais conhecido e tem bom suporte ao português. Ele é gratuito e roda no seu próprio servidor, o que ajuda em casos de dados sensíveis. Em contrapartida, ele só entrega o texto: a interpretação dos campos fica por sua conta, o que normalmente exige combinar com um modelo de linguagem ou com regras de extração.
Modelos de linguagem multimodais
Os assistentes de IA modernos conseguem receber a imagem do documento diretamente e devolver os campos em formato estruturado, como JSON. Para volumes moderados, essa abordagem é a mais rápida de colocar de pé: você envia a imagem, descreve os campos que quer e recebe os dados. O cuidado está na consistência e no custo por documento em larga escala, além da questão de privacidade, que veremos adiante. Se você ainda está avaliando qual assistente usar, vale ler sobre como escolher e implementar modelos de linguagem no contexto brasileiro.
Plataformas no-code
Ferramentas como Zapier, Make e n8n permitem montar o fluxo inteiro sem programar: o gatilho é o e-mail recebido, a ação seguinte envia o anexo para o serviço de extração, e a última grava os dados numa planilha ou no ERP. Para quem está começando, esse é o caminho mais rápido para validar a ideia antes de investir em algo maior. O guia de automação de processos com IA complementa bem essa abordagem.
Passo a passo: montando um fluxo simples para notas fiscais
Para tirar o assunto do abstrato, veja um roteiro enxuto que uma pequena empresa consegue executar em poucos dias, sem equipe de desenvolvimento.
- Mapeie o processo atual. Anote quem recebe as notas, por qual canal, quais campos são digitados e onde eles são lançados. Sem esse mapa, você automatiza o caos.
- Defina os campos mínimos. Comece pequeno: fornecedor, CNPJ, número da nota, data de emissão, valor total e vencimento. Campos extras, como itens e impostos, podem entrar depois.
- Crie a caixa de entrada única. Configure um e-mail dedicado ou uma pasta na nuvem e peça que fornecedores e colaboradores enviem tudo para lá.
- Monte o gatilho e a extração. Na ferramenta no-code escolhida, configure o gatilho "novo anexo recebido" e conecte ao serviço de OCR ou ao modelo de linguagem, instruindo-o a devolver os campos em formato estruturado.
- Adicione as regras de validação. Valide o CNPJ, confira se o valor é numérico e positivo, verifique duplicidade pelo número da nota e do fornecedor.
- Crie a fila de exceções. Tudo que falhar na validação cai numa planilha ou painel de revisão, com o documento original ao lado dos dados extraídos, para conferência humana rápida.
- Rode em paralelo por algumas semanas. Continue o processo manual enquanto a automação roda, e compare os resultados. Isso revela as falhas antes que causem prejuízo real.
O papel da revisão humana: automatizar não é abandonar
O erro mais comum de quem começa é tentar chegar a 100% de automação logo de cara. Isso quase nunca funciona e costuma gerar desconfiança na equipe quando os primeiros erros aparecem. A abordagem mais saudável é pensar em "automação com exceções".
Na prática, uma parcela grande dos documentos, especialmente os de fornecedores recorrentes e de boa qualidade, passa direto. Uma parcela menor, com imagem ruim, layout incomum ou dados que falharam na validação, vai para revisão. O ganho de tempo vem de a pessoa deixar de digitar tudo e passar a conferir apenas as exceções. À medida que você ajusta as regras e as instruções ao modelo, a proporção de documentos que passam direto tende a crescer.
Vale também registrar, para cada documento processado, quem revisou, quando e o que foi alterado. Esse histórico serve para auditoria e para descobrir quais tipos de documento mais erram, indicando onde melhorar.
Privacidade e LGPD: o cuidado que não pode ficar para depois
Documentos empresariais carregam dados pessoais e sigilosos: CPF, endereço, dados bancários, valores contratuais. Ao enviar esses arquivos para um serviço de terceiros, você está realizando tratamento de dados e precisa considerar as obrigações da Lei Geral de Proteção de Dados.
Alguns pontos práticos para avaliar antes de colocar a automação em produção:
- Onde os dados são processados e armazenados? Verifique a localização dos servidores e as cláusulas de transferência internacional do fornecedor.
- O fornecedor usa seus documentos para treinar modelos? Muitos serviços corporativos oferecem opção de desativar isso, mas é preciso conferir e configurar.
- Há contrato de tratamento de dados? Um acordo claro entre você e o operador é parte da conformidade.
- Quanto tempo os arquivos ficam retidos? Prefira serviços que permitam apagar o documento logo após a extração.
- Quem na sua equipe tem acesso à fila de exceções? Restrinja o acesso ao mínimo necessário.
Para dados muito sensíveis, rodar um OCR de código aberto no seu próprio ambiente pode ser a opção mais segura. Se você ainda não estruturou a conformidade da empresa, o material sobre LGPD na prática ajuda a organizar os primeiros passos, e a leitura sobre segurança de APIs é importante porque a automação cria novas integrações que precisam ser protegidas.
Erros comuns que derrubam projetos de automação documental
Ignorar a qualidade da entrada
Foto tirada no escuro, documento dobrado e PDF de baixíssima resolução derrubam qualquer OCR. Orientar quem envia os documentos (uma instrução simples de "foto reta, boa luz, sem sombra") costuma melhorar muito o resultado sem custo nenhum.
Não tratar duplicidades
Fornecedores reenviam a mesma nota, e colaboradores encaminham o mesmo e-mail duas vezes. Sem uma checagem de duplicidade, você pode pagar duas vezes pelo mesmo documento.
Confiar cegamente no resultado
Modelos de linguagem podem "preencher" um campo com um valor plausível quando o dado não está legível. Por isso a validação por regras e a possibilidade de o modelo responder "não encontrado" para campos ausentes são fundamentais. Instrua explicitamente: se o campo não estiver visível, devolva vazio em vez de supor.
Automatizar um processo ruim
Se o fluxo atual tem etapas desnecessárias, aprovações redundantes ou dados duplicados em três planilhas, automatizar apenas acelera o desperdício. Simplifique primeiro, automatize depois.
Esquecer a manutenção
Fornecedores mudam o layout, municípios alteram o formato da NFS-e e serviços atualizam seus modelos. Reserve um momento periódico para revisar a taxa de exceções e ajustar as regras.
Como medir se a automação está valendo a pena
Sem números, você não sabe se o projeto funciona. Defina poucos indicadores desde o início e acompanhe-os com regularidade:
- Tempo médio por documento antes e depois da automação.
- Taxa de documentos que passam direto sem intervenção humana.
- Taxa de erros encontrados depois do lançamento, que deve cair com o tempo.
- Custo por documento, somando o serviço de OCR e a hora da pessoa que revisa.
- Tempo entre o recebimento e o lançamento, que impacta diretamente o controle de contas a pagar.
Um benefício que costuma passar despercebido é o ganho de qualidade de vida da equipe. Tirar da rotina o trabalho mais monótono libera as pessoas para tarefas de análise, negociação com fornecedores e controle, que agregam mais valor. Esse efeito é parte do retorno do projeto, mesmo que seja difícil de colocar numa planilha.
Próximos passos: de documentos soltos a processos conectados
Depois que a leitura automática de documentos estiver estável, o passo seguinte é conectá-la ao resto da operação. Notas extraídas podem alimentar a conciliação bancária, disparar aprovações por mensagem, atualizar o fluxo de caixa e até alertar sobre vencimentos próximos. Para quem quer ampliar a visão, o artigo sobre fluxos de trabalho com inteligência artificial mostra como encadear várias automações em sequência.
O ponto central é começar pequeno. Escolha um tipo de documento, um canal de entrada e um conjunto enxuto de campos. Rode em paralelo, meça, ajuste e só então amplie. A tecnologia hoje está madura o suficiente para que uma empresa pequena obtenha ganhos reais, desde que respeite três princípios: validar os dados, manter uma revisão humana para as exceções e tratar a privacidade como requisito desde o primeiro dia.
Patrícia Braga
Jornalista de tecnologia que cobre o ecossistema de startups e inovação no Brasil. Escreve sobre tendências digitais e ferramentas para empreendedores.